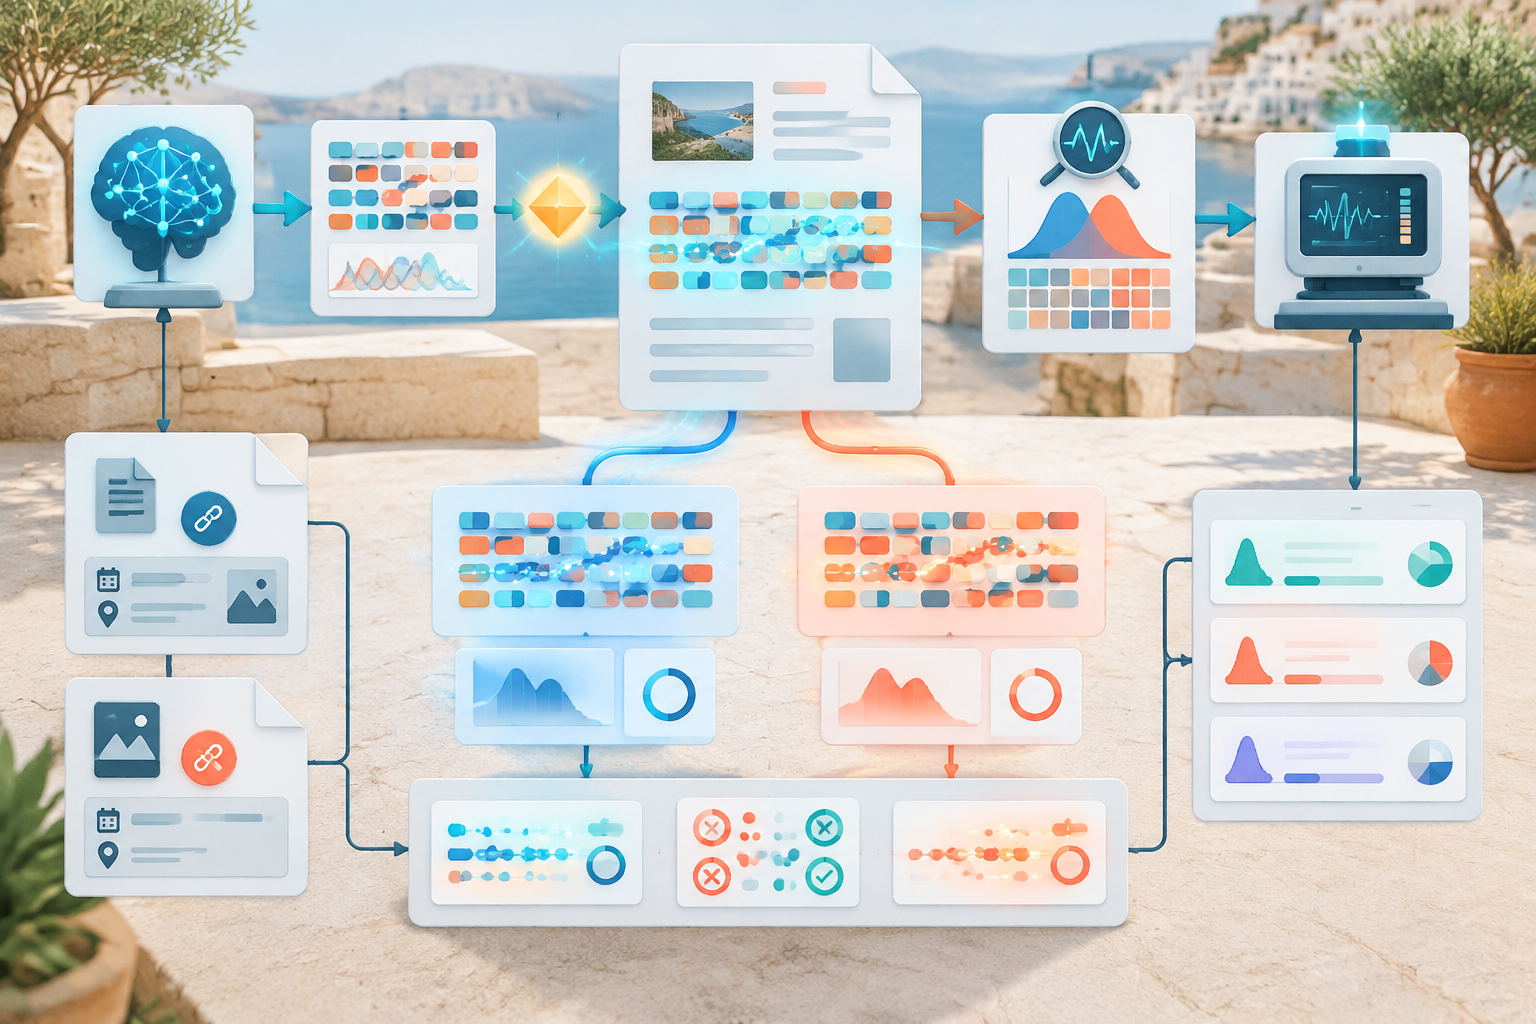
Per capire che cosa può indicare davvero una filigrana testuale occorre tenere separati tre elementi: il modo in cui il segnale viene inserito, il rilevatore incaricato di cercarlo e le modifiche subite dal contenuto dopo la generazione.
Che cos’è un watermark testuale
Una filigrana digitale applicata al testo non deve per forza consistere in spazi nascosti, caratteri Unicode o simboli estranei. Nel caso descritto da Anthropic, il segnale è legato alla sequenza delle parole selezionate dal modello. Alla lettura, quindi, non si vede nulla.
Quando genera una frase, un modello linguistico valuta più continuazioni plausibili. Due parole possono avere un significato molto simile e produrre una frase altrettanto leggibile; la scelta tra le due, però, modifica il comportamento statistico della sequenza. È proprio in queste decisioni, poco rilevanti per il senso complessivo, che il watermark trova spazio.
Per Claude, Anthropic ha indicato una versione di SynthID-Text di Google DeepMind, una tecnologia presentata nella letteratura scientifica del 2024. Il metodo combina una chiave segreta con una casualità controllata nel campionamento dei token, cioè delle unità utilizzate dal modello per costruire il testo. Non aggiunge una stringa che si possa individuare con una ricerca automatica.
Se il brano è abbastanza lungo, la distribuzione delle scelte può allontanarsi da quella attesa in un testo privo di marcatura. Un detector che dispone della chiave controlla allora la presenza del pattern. Il risultato è una probabilità o un punteggio, non una certezza assoluta sull’autore.
Come il rilevatore cerca il segnale
Il controllo non consiste nell’analizzare lo stile, nel riconoscere formule ricorrenti o nel decidere se una prosa sembri “da AI”. Un watermark statistico osserva piuttosto il rapporto tra le parole, il contesto in cui compaiono e la regola pseudo-casuale usata dal modello durante la generazione.
In forma semplificata, il procedimento funziona così:
- il modello calcola le continuazioni compatibili con il testo già prodotto;
- alle alternative assegna un valore determinato dal contesto e dalla chiave;
- seleziona il token seguendo la procedura di campionamento marcata;
- su una sequenza di molti token, misura se il risultato supera quello che ci si attenderebbe dal caso.
Questa descrizione non coincide con il metodo green list/red list spesso richiamato nelle spiegazioni divulgative. In quel caso il vocabolario viene diviso in insiemi di parole favorite e sfavorite. SynthID-Text interviene invece sulla casualità del campionamento e sulla scelta tra candidati plausibili. Le due tecniche appartengono alla stessa famiglia di watermark statistici, ma non rappresentano la medesima implementazione.
Il testo, proprio per questo, non deve cambiare in modo evidente. Anthropic sostiene che significato, qualità e leggibilità restino sostanzialmente invariati. La scelta di una parola rispetto a un’alternativa, però, fa parte del meccanismo: il sistema cerca di mantenere la variazione sotto la soglia percepibile dal lettore, non di eliminarla dal punto di vista matematico.
ChatGPT e Claude: che cosa è documentato
Per Claude, Anthropic ha annunciato una marcatura attiva sui modelli lanciati dal 2 agosto 2026 e un aggiornamento progressivo dei modelli precedenti. La copertura dichiarata è mondiale e comprende le diverse superfici di accesso. Nelle informazioni disponibili non è documentata una possibilità di opt-out per disattivare il sistema.
L’azienda ha comunicato anche l’arrivo di strumenti di rilevamento destinati agli utenti e a soggetti esterni. Al momento considerato, però, non risultava disponibile una API pubblica con informazioni complete sulle soglie, sui margini di errore e sulle condizioni d’uso.
Per ChatGPT il quadro è diverso. Le informazioni raccolte parlano di proposte, ricerche e discussioni sul watermarking dei testi, ma non attestano che OpenAI abbia adottato nei prodotti ChatGPT un watermark testuale operativo e generalizzato. Non si può quindi trasferire automaticamente a ChatGPT quanto Anthropic ha dichiarato per Claude.
SynthID-Text ha un riferimento tecnico distinto: è una tecnologia di Google DeepMind. Il suo funzionamento permette di capire come potrebbe essere costruita un’architettura di questo tipo, ma non dimostra che la stessa marcatura venga usata da ogni modello linguistico, inclusi ChatGPT o altri servizi.
Watermark e detector stilistici non sono uguali
Un rilevatore basato sullo stile cerca tracce linguistiche: una sintassi molto uniforme, determinate scelte lessicali, ripetizioni, prevedibilità o caratteristiche statistiche generiche. Gli stessi segnali possono comparire in testi umani formali e generare falsi positivi.
Il detector di un watermark lavora su una firma associata a una procedura di generazione precisa. Senza la chiave o senza l’accesso al sistema del fornitore, un servizio generico non può sostenere di aver letto quel segnale limitandosi a osservare la prosa.
La distinzione pesa in ambito scolastico, editoriale e professionale. Un punteggio che definisce un testo “probabilmente scritto dall’AI” non equivale al rilevamento di un watermark Claude. Tantomeno consente di attribuire automaticamente il contenuto a ChatGPT, Claude o a un altro modello.
Quanto resiste alle modifiche
La tenuta del segnale dipende dalla quantità di testo e dall’intervento effettuato. Un semplice copia-incolla lascia invariata la sequenza delle parole e, secondo Anthropic, può conservarlo. Anche alcune correzioni leggere possono lasciarne una parte.
La riscrittura cambia la situazione. Le trasformazioni più problematiche comprendono:
- parafrasi estese, con sostituzioni che riguardano lessico e sintassi;
- traduzioni, perché il contenuto viene ricostruito in un’altra lingua;
- fusione con materiale proveniente da fonti differenti;
- testi molto brevi, nei quali il numero di token non consente una valutazione solida;
- interventi umani limitati ad alcune sezioni, che lasciano soltanto un segnale parziale.
Nei contenuti fattuali le alternative linguistiche possono essere meno numerose. Nel codice la sintassi restringe ancora di più le possibilità di scelta. Una revisione svolta da Claude può dunque marcare soprattutto la parte generata o modificata dal modello, senza estendere il segnale all’intero documento di partenza.
La ricerca sul watermarking ha già mostrato che alcune modifiche successive possono indebolire o cancellare gli schemi di marcatura mantenendo una qualità accettabile. Questo non dimostra che ogni attacco abbia effetto contro Claude. Indica però che un segnale statistico non va considerato indistruttibile.
File, immagini e metadati C2PA
Testo e file seguono meccanismi differenti. Per le immagini in formato PNG, JPG e SVG, Anthropic ha previsto metadati di provenienza firmati secondo lo standard aperto C2PA. L’acronimo indica la Coalition for Content Provenance and Authenticity, il consorzio che definisce sistemi interoperabili per attestare l’origine e l’integrità dei contenuti digitali.
La firma può indicare chi ha prodotto il file e se il file è stato modificato dopo la generazione. Non coincide, però, con il watermark testuale. Un nuovo salvataggio, una conversione, un ridimensionamento effettuato da un sistema editoriale o anche uno screenshot possono cancellare i metadati.
Nel testo, invece, il segnale è incorporato nella scelta delle parole e non in un allegato del documento. Per questo il copia-incolla può conservarlo, mentre una riscrittura sostanziale può eliminarlo. L’assenza di metadati C2PA o di watermark non dimostra, da sola, che il contenuto abbia origine umana.
Falsi positivi, falsi negativi e accesso
Un risultato positivo può indicare, al massimo, che il testo è stato processato da Claude. Non prova che il modello lo abbia scritto interamente da zero: potrebbe aver corretto, tradotto, riassunto o riformattato una bozza umana.
Anche un risultato negativo ha un valore limitato. Il testo può provenire da un altro modello, da una versione precedente non ancora aggiornata oppure essere stato modificato fino a perdere il pattern. La lunghezza insufficiente, da sola, può rendere il conteggio poco affidabile.
Finché il detector ufficiale non sarà accessibile, scuole, aziende, redazioni e piattaforme dovranno distinguere tra una verifica specifica e una stima generica. Un software che analizza soltanto lo stile non può essere presentato come uno strumento capace di leggere il watermark di Claude.
Le ricadute pratiche riguardano quattro situazioni:
- scuola e università: il segnale può indirizzare una verifica, ma non sostituire il confronto con le bozze, la cronologia del lavoro e un colloquio;
- recruiting: una candidatura non dovrebbe essere esclusa sulla base di un singolo punteggio automatico;
- editoria: la provenienza tecnica va distinta dall’autorialità, soprattutto quando l’AI ha svolto soltanto un’attività di revisione;
- moderazione: il watermark può contribuire alla classificazione, ma deve essere valutato insieme al contesto e ad altre evidenze.
La regola pratica sulla provenienza
Il watermark testuale può fornire un indizio tecnico di provenienza. Non è una sentenza autonoma. Per attribuire un contenuto servono almeno un sistema di rilevamento affidabile, informazioni sulla versione del modello, una soglia di errore pubblica e una valutazione delle modifiche intervenute.
Sulla base delle informazioni disponibili, Claude è il caso documentato di adozione operativa tra i servizi citati. ChatGPT non può essere inserito nello stesso quadro senza una dichiarazione o una documentazione tecnica che dimostri l’attivazione di un sistema analogo. Anche l’uso di SynthID-Text da parte di Google indica una possibile strada tecnica, non l’esistenza di una marcatura universale dei testi generati dall’intelligenza artificiale.
La domanda utile, quindi, non è soltanto “questo testo è dell’AI?”. Occorre chiedersi quale modello possa averlo processato, quale segnale sia stato cercato, quanto testo sia rimasto invariato e quali trasformazioni abbia subito. Senza queste informazioni, una probabilità statistica rischia di diventare una certezza che i dati non autorizzano.